Die KI-Token-Ökonomie
KI kann Ihnen und Ihrem Team Superkräfte verleihen, bringt jedoch versteckte Managementverantwortung mit sich.
KI kann Ihnen und Ihrem Team Superkräfte verleihen, bringt jedoch versteckte Managementverantwortung mit sich.
Gedankenexperiment: Stellen Sie sich vor, Ihnen wird ein Freelancer mit diesen seltsamen Eigenschaften zugewiesen.
Auf dem Papier glänzt dieser Mitarbeiter mit enzyklopädischem Wissen, arbeitet blitzschnell und übernimmt jede Aufgabe. Doch er birgt drei gravierende Schwächen.
Knows about everything you ask them, and can produce results fast without breaks.
No task too big or too niche — it will take a swing at whatever you hand it.
Never stops, never sleeps, unless you stop paying.
Takes tasks literally, fills gaps with assumptions, never pushes back.
No flat day rate. Every prompt, tool call, and correction adds to the tab.
Every new conversation starts from zero. Yesterday’s work never happened.
Es ist ein LLM — aber wie würden Sie es führen, wenn es ein Mensch wäre?
Das Anleiten eines KI-Agenten verlangt dieselbe Delegations- und Review-Disziplin wie das Einarbeiten externer Spezialisten.
door 1 · the individual
5–20× individual throughput by directing synthetic labor.
door 2 · the organization
Upskilling whole teams into fluent directors of automated systems.
Neue Technologie bringt neue Disziplinen hervor, damit Menschen Schritt halten können.
Vom Prompt Engineering 2023 über Context Engineering 2024 und Harness Engineering 2025 zur Token-Ökonomie von heute.
chat workflow
Phrasing, few-shot examples, and asking clearly.
agentic workflow
AGENTS.md, skills, and compact structured memory.
autonomous workflow
Tools, deterministic tests, and guardrail verification.
emerging
Self-improving autonomous feedback cycles.
Token Economy — the currency of every era
Für einen echten Freelancer brauchen Sie einen Business Case. KI stellt einfach Rechnungen.
Eine Beraterrechnung über 3.200 € erfordert Bestellungen und Freigaben. KI häuft dieselben Kosten still über tausende Mikro-Prompts an.
Sie verantworten nun ein Budget, für das Sie sich nie gemeldet haben.
Für Routineaufgaben stets Spitzenmodelle einzusetzen, verbrennt Kapital. Wirtschaftlich gewinnt, wer das Ergebnis pro Euro optimiert.
Outcome per euro
At 93%, both models clear the bar — the cheaper one wins ≈5× outcome per euro.
Today’s prices are subsidized — vendors sell intelligence below cost to build adoption. When subsidies expire, outcome per euro decides who survives.
Token sind die Basiseinheit für LLMs — jedes einzelne wird abgerechnet.
LLMs berechnen statistische Wahrscheinlichkeiten über numerische Token. Jedes Wort und jedes Zeichen schlägt als abrechenbare Einheit zu Buche.
Every token is billed 4 ways
Die meisten Tools verbergen den Zähler — so sieht er tatsächlich aus.
Typische Zusammensetzung einer 200k-Sitzung: System-Prompts, Gesprächsverlauf, Tool-Aufrufe und abgerufene Dokumentation.
Der Zähler wird mit Absicht versteckt.
Undurchsichtigkeit ist ein Produktmuster: reibungsloser Einstieg, gewohnte Abläufe und überraschend hohe Monatsrechnungen.
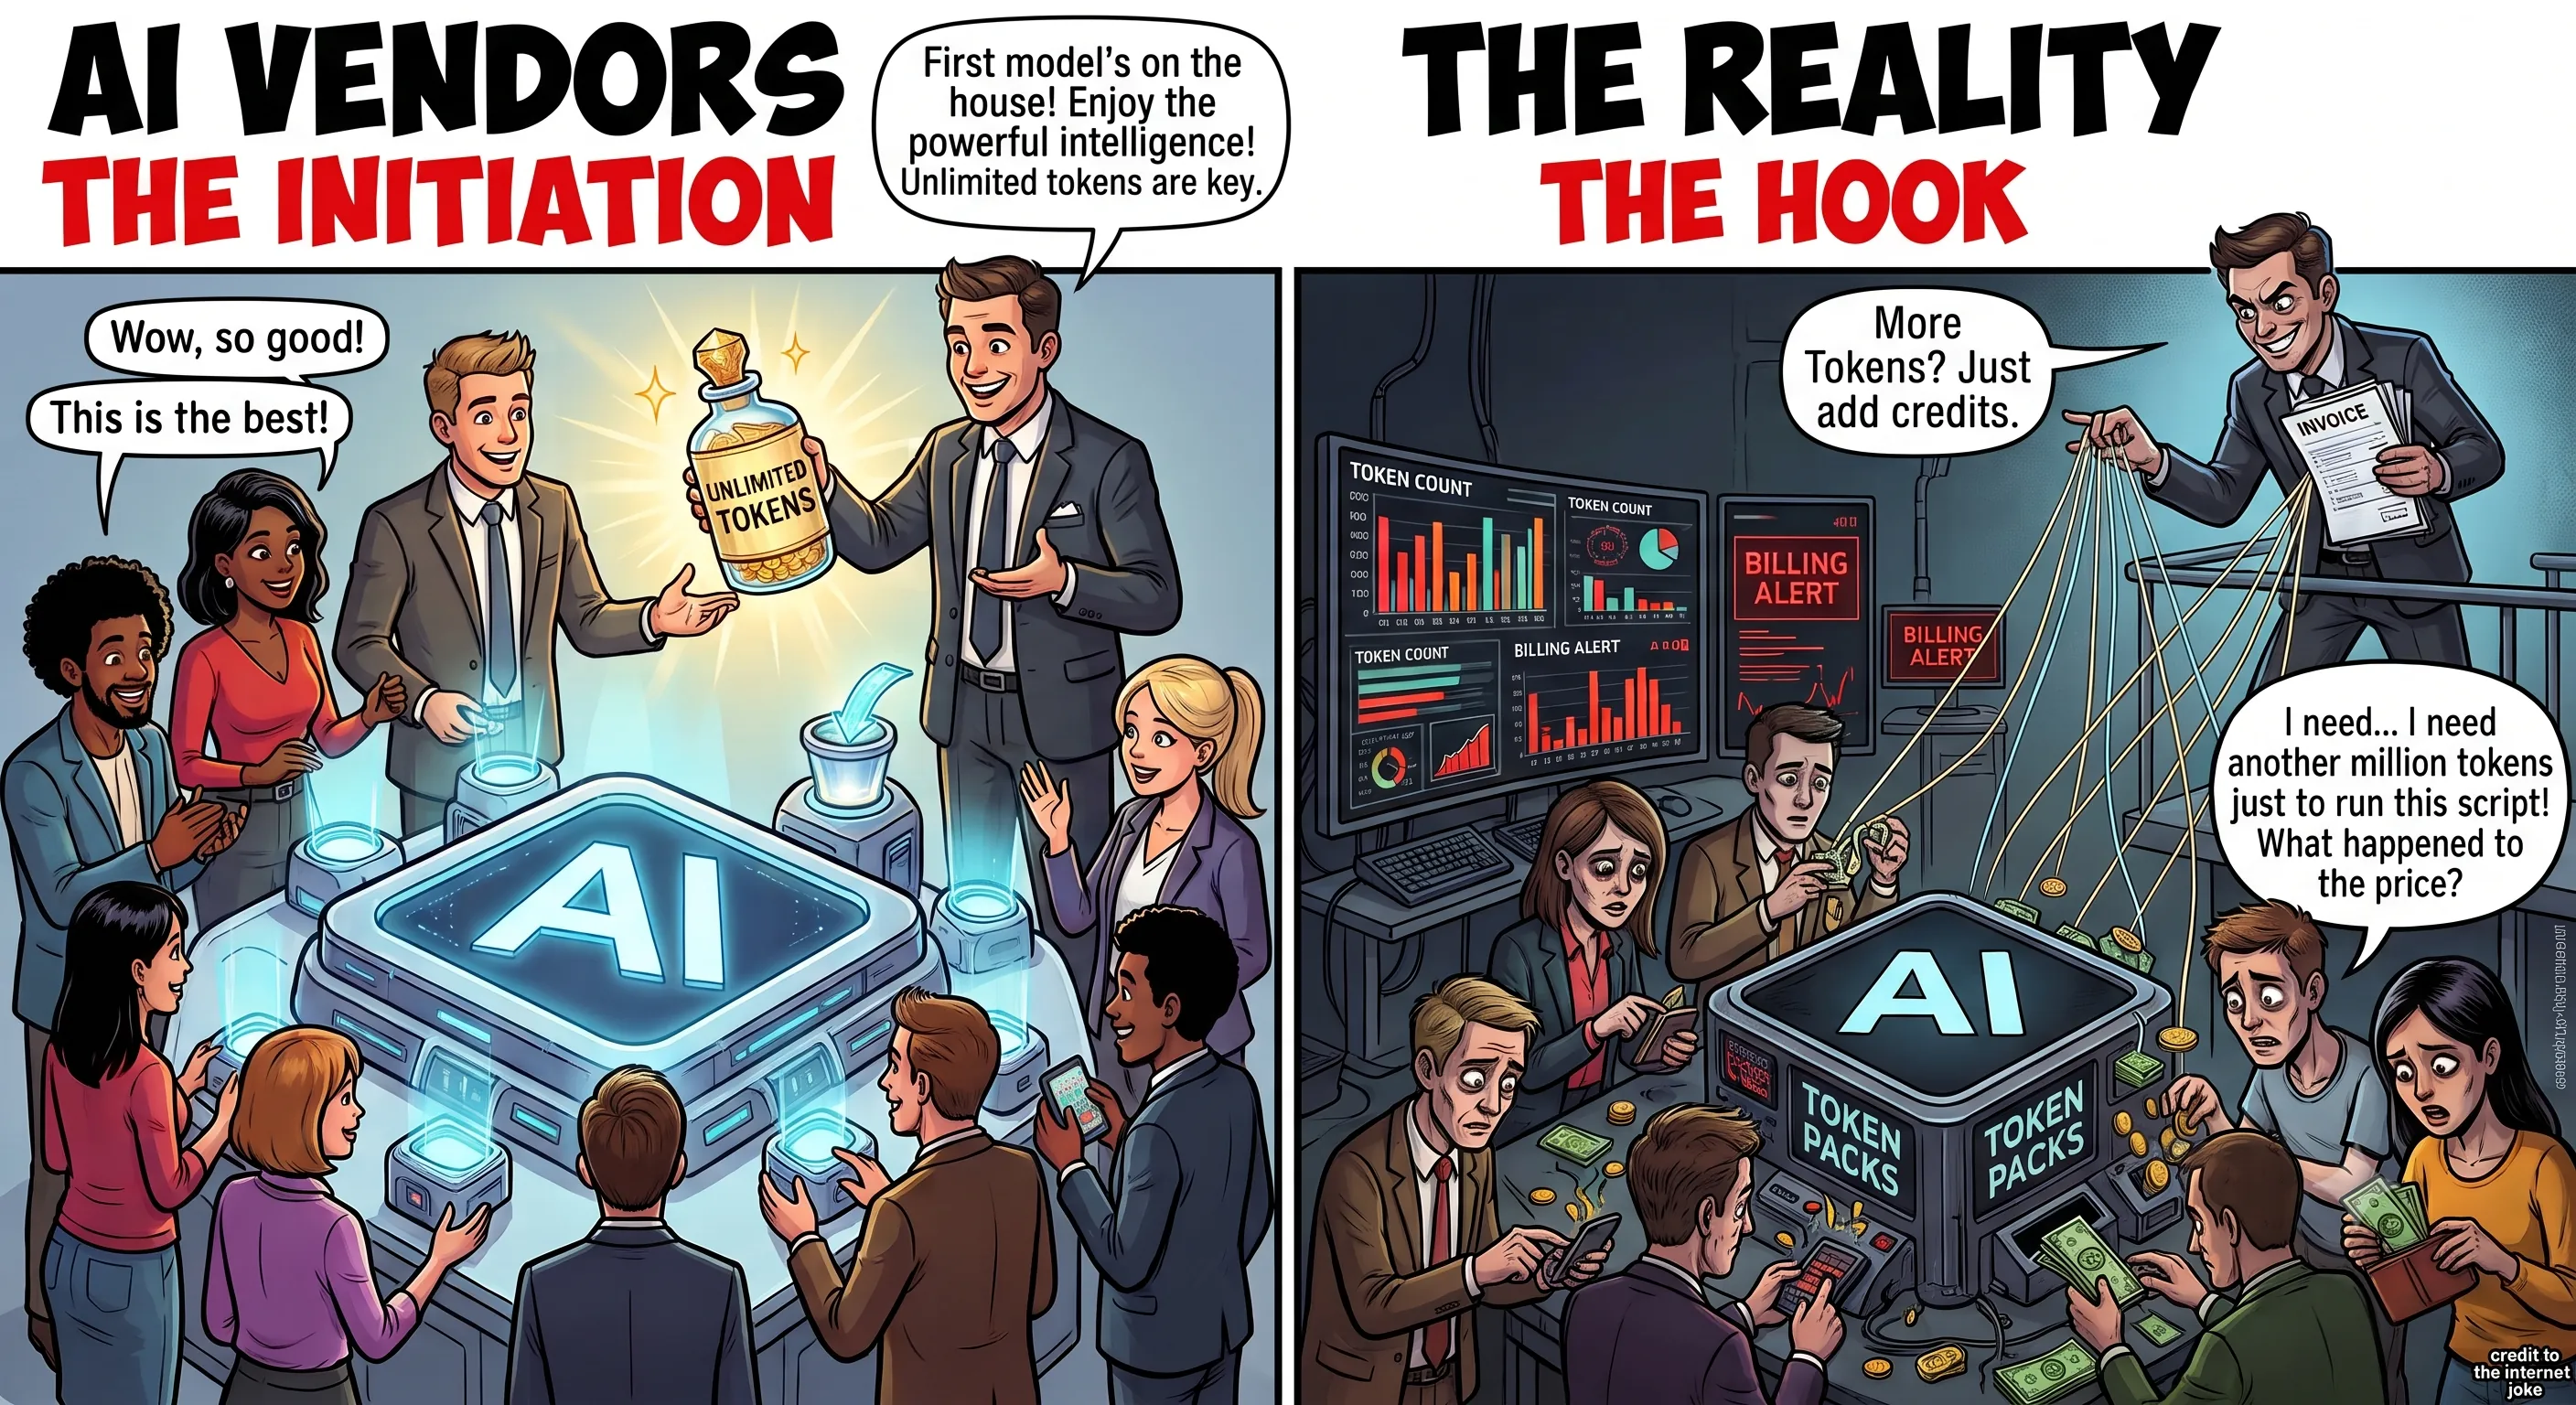
Unlimited on the house. The intelligence feels like magic and the bill is invisible — so you build the habit.
Now you are fluent — and the meter is gone. Out of credits? Just top up. The real rate never shows.
Das Kontextfenster ist die Aufmerksamkeitsspanne des Modells.
Token sammeln sich im Kontextfenster. Füllt es sich, lässt die Aufmerksamkeit nach und entscheidende Instruktionen gehen verloren.
Wie wichtige Instruktionen in der Mitte untergehen.
Modelle erfassen Anfang und Ende eines Kontexts präzise, doch die Mitte versinkt in einem Tal nachlassender Aufmerksamkeit.
Ab etwa halber Fülle verliert das Modell den Faden.
Unter 50 % liegt die Smart Zone. Darüber sinkt die Präzision, ab 75 % drohen Halluzinationen. Drei Hebel: Beobachten, Komprimieren, Übergeben.
Watch the gauge before it degrades — catch it while it is still grounded.
Summarize where you are into a clean handoff, then start fresh from it.
Eine kleine Fehlerbehebung summiert sich auf ~73.000 Token Kontext.
Agenten-Schleifen senden bei jedem Tool-Aufruf und Denkschritt den gesamten bisherigen Verlauf erneut.
Dieselbe Fehlerbehebung, verglichen über Modelle.
Abrechnung erfolgt pro verarbeitetem Token in jedem Schritt. Eine Routineaufgabe führt zu einer 14-fachen Preisspanne zwischen Modellen.
~14× spread for identical output. At 50 fixes a day, that is roughly $6 vs $77 per developer per day — before anyone has shipped a single feature. This is why model routing matters.
Mein Modell-Stack: Ein Workflow, viele Modelle.
Jede Phase nutzt das wirtschaftlichste Modell: Pauschal-Chats für Ideen, Spitzenmodelle für Architektur, schnelle Modelle für Code.
Web chat · flat-rate
Claude Code CLI · Desktop
All CLI
Drei Hebel zur Optimierung Ihrer Token-Ökonomie
Kombinieren Sie automatisierte Werkzeuge (rtk, Kompression) mit strukturierter Kontextsteuerung und disziplinierten Teamgewohnheiten.